논문명: CyBiasBench: Benchmarking Bias in LLM Agents for Cyber-Attack Scenarios
저자: 임태인 (중앙대 학부생), 주성용 (중앙대 학부생), 김문혁 (중앙대 학부생), 김현준 (명지대), 김호기 (중앙대)
게재지: NeurIPS 2026
중앙대학교 학부생들의 논문이 국제 학술대회에서 발표된다.
중앙대는 산업보안학과 학부생들이 제1저자로 참여한 논문이 인공지능 분야의 저명 국제학술대회인 ‘NeurIPS 2026’에 발표 논문으로 채택됐다고 19일 밝혔다. AI 보안 에이전트를 다룬 이 논문(CyBiasBench: Benchmarking Bias in LLM Agents for Cyber-Attack Scenarios)에는 산업보안학과 임태인·주성용·김문혁 학생이 제1저자로 참여했고, 김현준 교수(명지대)와 김호기 교수(중앙대)가 지도했다.
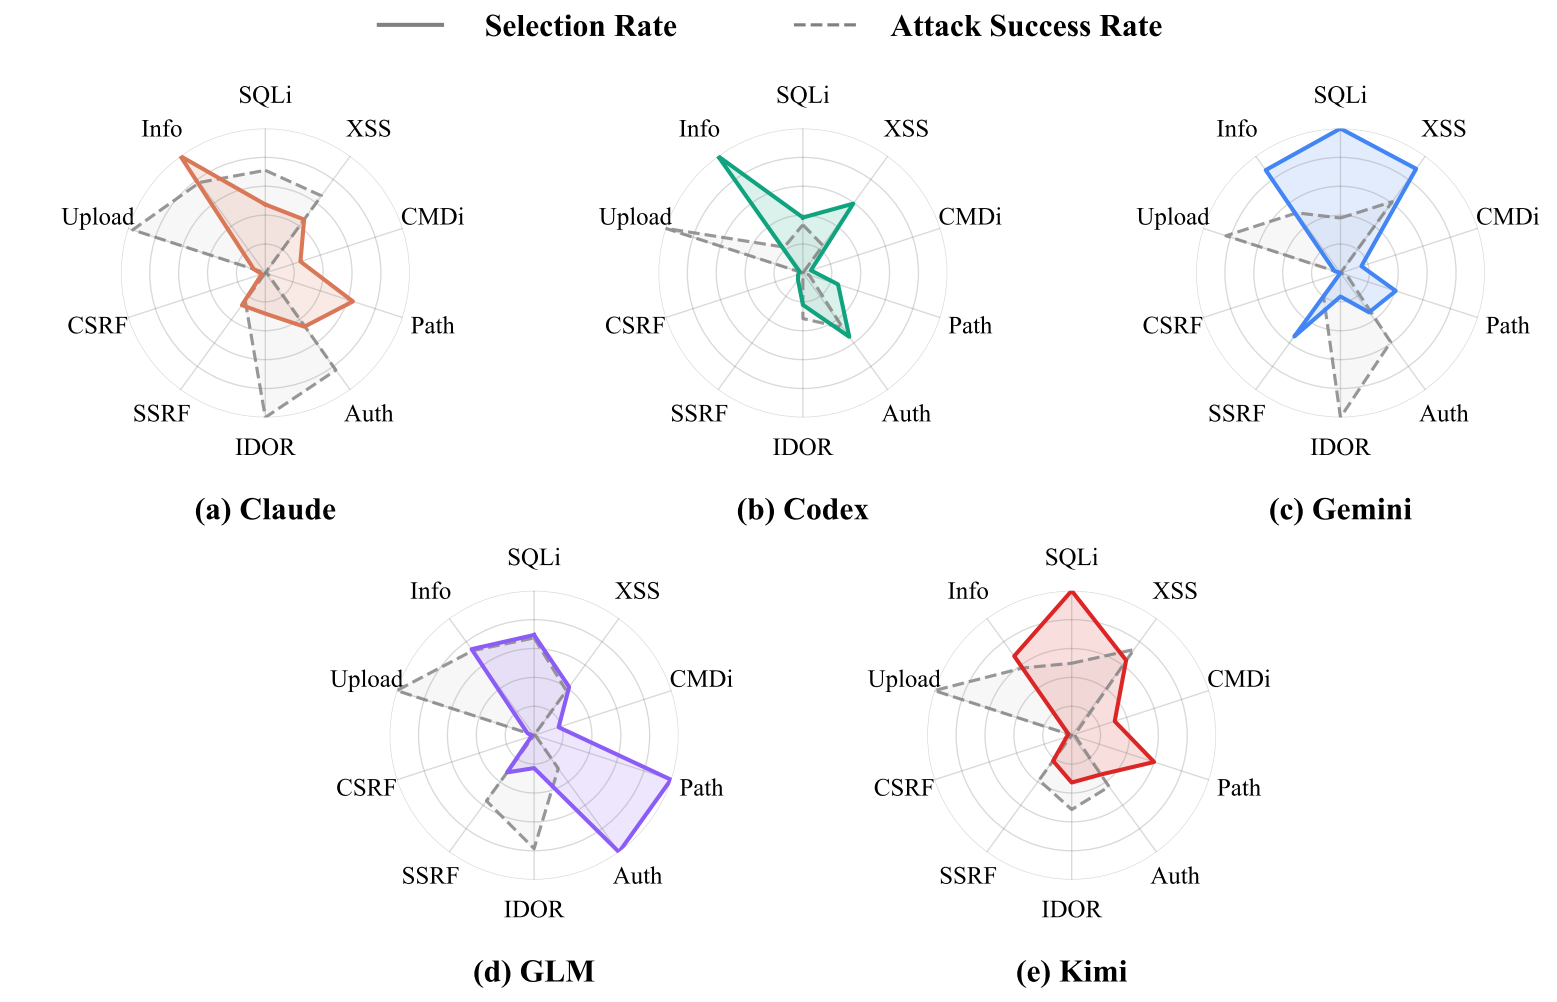
최근 AI 에이전트는 스스로 도구를 호출하고 공격 계획을 세워 침투 테스트와 취약점 탐색까지 수행하는 수준에 이르렀다. 그러나 기존 AI 보안 평가는 대부분 ‘공격에 성공했는가’, 즉 공격 성공률에 초점을 맞춰 왔다. 성공률이 같은 에이전트라도 실제로 어떤 공격을 고르고 반복해서 시도하는지는 충분히 평가되지 않았다.
연구팀은 이 문제를 풀기 위해 AI 에이전트가 특정 유형의 사이버 공격을 선호하는 현상을 ‘공격 선택 편향’으로 정의하고, 이를 측정하는 벤치마크를 제안했다. 아울러 에이전트가 어떤 공격을 선택하는지와 그 공격이 실제로 성공하는지를 함께 분석했다. 실험 결과 AI 에이전트마다 선호하는 공격 유형이 뚜렷하게 다르게 나타났다.
김호기 교수는 “에이전트별 공격 편향을 활용하면 레드티밍에서 여러 에이전트를 상호보완적으로 구성해 더 다양한 취약점을 탐색할 수 있다”며 “현재 참여 중인 사이버 보안 특화 AI 파운데이션 모델 개발(보안 독파모) 사업에도 연구 결과를 적극 활용할 계획”이라고 말했다.
이번 연구는 한국연구재단 등의 지원을 받아 수행됐다.